
Mientras trabajaba en Clínica, un proyecto personal en el que estoy construyendo un sistema de gestión hospitalaria con microservicios, me encontré con algo que no tenía previsto: no todos los servicios terminaron con la misma arquitectura. Algunos están construidos siguiendo un enfoque hexagonal y otros utilizan una arquitectura por capas.
Al principio, cuando empecé a rehacer el sistema servicio por servicio, pensaba que lo más lógico era mantener la misma estructura en todos. Si los tres servicios anteriores estaban en hexagonal, ¿por qué el siguiente iba a ser diferente?
La duda me apareció al trabajar en el servicio de profesionales. Después de revisar lo que realmente necesitaba ese servicio, terminé tomando otra decisión: hacerlo por capas.
No fue porque hubiera dejado de gustarme la arquitectura hexagonal. Simplemente, en ese servicio no encontré un problema que justificara toda la estructura adicional que implica.
Esto me llevó a una conclusión que antes no tenía tan clara: la arquitectura no tiene por qué ser idéntica en todos los microservicios de un mismo sistema. Lo importante es que cada decisión tenga una razón y que no se convierta en una excusa para trabajar sin orden.
Este artículo es una explicación de cómo llegué a esa decisión y de lo que he encontrado al trabajar con ambos estilos.
Las dos arquitecturas, explicadas de forma sencilla
Antes de entrar en los detalles, esta es la diferencia que más me importa entre las dos.
Arquitectura por capas
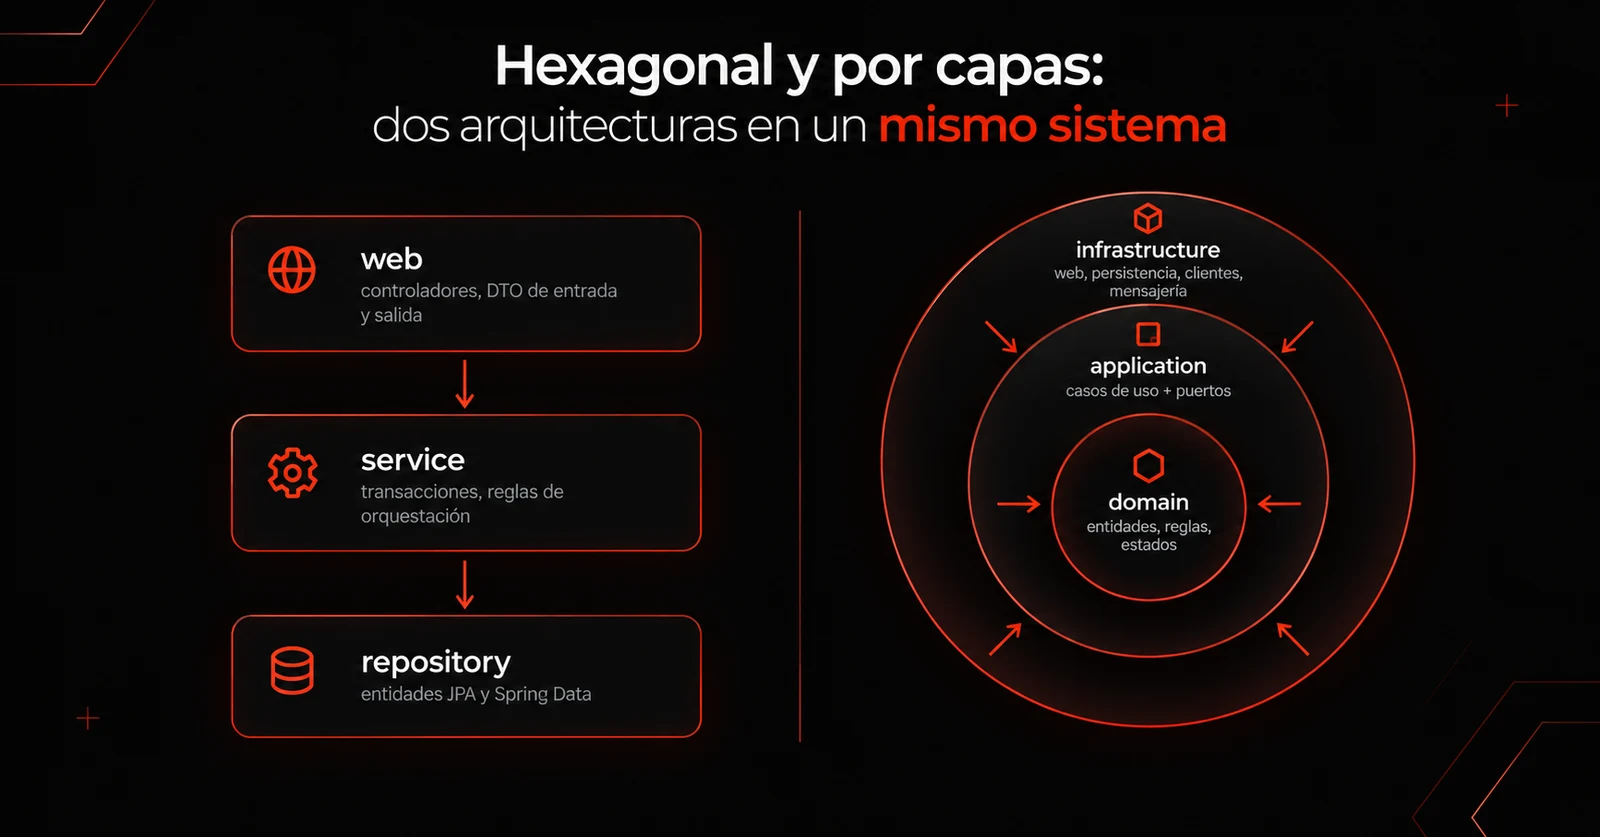
En el servicio de profesionales, la estructura es bastante directa:
web
  controladores, DTO de entrada y salida
       ↓
service
  transacciones, reglas de orquestación
       ↓
repository
  entidades JPA y Spring Data
La capa web recibe la petición y se comunica con la capa de servicio. Esta última se encarga de coordinar la operación y utilizar los repositorios para acceder a los datos.
Es una estructura que resulta familiar para cualquiera que haya trabajado con Spring Boot.
Arquitectura hexagonal
En los servicios donde estoy utilizando arquitectura hexagonal, la idea es que el dominio y los casos de uso no dependan directamente de la infraestructura.
Una representación simplificada sería:
infrastructure
  web, persistencia, clientes, mensajería
       │
       ↓
application
  casos de uso + puertos
       │
       ↓
domain
  entidades, reglas, estados
Las dependencias importantes apuntan hacia el interior. La infraestructura implementa los puertos que necesitan los casos de uso y el dominio.
Por ejemplo, el dominio puede definir una interfaz para guardar pacientes, mientras que una implementación basada en JPA se encarga de hacer el trabajo real.
La diferencia importante, al menos desde mi punto de vista, no está en cuántas carpetas tiene cada proyecto. Está en quién define las interfaces y de quién depende cada parte del sistema.
Quién termina definiendo el contrato
Una de las diferencias que más se nota cuando se escribe código es la relación entre el servicio y el repositorio.
En el servicio de profesionales, el caso de uso depende directamente de una interfaz de Spring Data:
@Service
public class CatalogueService {

    private final SpecialtyRepository specialties;
    private final SubSpecialtyRepository subSpecialties;
    private final Clock clock;

    @Transactional
    public SpecialtyView register(NewSpecialty command) {

        String code = Rules.upper(command.code());

        if (specialties.findByCode(code).isPresent()) {
            throw new PractitionersException.SpecialtyCodeAlreadyUsed();
        }

        Specialty registered = specialties.saveAndFlush(
                Specialty.register(command.code(), command.name()));

        return SpecialtyView.of(registered);
    }
}
SpecialtyRepository es una interfaz de Spring Data que pertenece a la parte de persistencia. El servicio la utiliza tal como está definida.
En el servicio de pacientes, en cambio, la interfaz que necesita el caso de uso la define el propio servicio:
public interface Patients {

    Patient save(Patient patient);

    Optional<Patient> findByUuid(UUID uuid);

    Optional<Patient> findByDocument(IdentityDocument document);

    boolean existsByDocument(IdentityDocument document);
}
La implementación JpaPatients vive en infraestructura. Es allí donde se utiliza Hibernate o Spring Data, pero el dominio no necesita conocer esos detalles.
Si uno mira solamente el cuerpo de las operaciones, la diferencia puede parecer pequeña. En los dos casos se busca un registro, se valida algo, se construye una entidad y se guarda.
La diferencia está principalmente en las dependencias y en cómo se organiza el código alrededor de esa operación.
Y aquí hay algo que me parece importante aclarar: ninguna de las dos arquitecturas escribe las reglas de negocio por nosotros. Las reglas siguen siendo responsabilidad del diseño del dominio y de los casos de uso. La arquitectura ayuda a organizar las dependencias, pero no sustituye ese trabajo.
Cuándo empieza a importar la diferencia
La diferencia entre ambos estilos se vuelve más evidente cuando el servicio tiene que comunicarse con otros sistemas.
Por ejemplo, el registro de pacientes necesita consultar información del servicio de contratación para validar una aseguradora. Esa consulta puede fallar por diferentes motivos: el otro servicio puede estar caído, puede haber un problema de red o puede no existir el paciente afiliado.
Además, no todas esas situaciones significan lo mismo para el negocio.
En ese caso, el puerto puede representar explícitamente los posibles resultados:
public sealed interface PayerLookup {

    record Found(Payer payer) implements PayerLookup {}

    record NotFound() implements PayerLookup {}

    record Unavailable() implements PayerLookup {}

    record NotAffiliated() implements PayerLookup {}
}

public interface PayerDirectory {

    PayerLookup findByUuid(UUID uuid);
}
La implementación concreta puede utilizar Feign, un circuit breaker y una caché. Todos esos detalles quedan en infraestructura.
El caso de uso, por su parte, no necesita saber qué cliente HTTP se está utilizando. Solo recibe uno de los resultados definidos por el contrato y decide qué hacer con él.
Por ejemplo, registrar un paciente podría responder con un 503 si no fue posible consultar la aseguradora, mientras que una consulta de información existente podría continuar sin ese dato, dependiendo de la regla del negocio.
Aquí sí encuentro una ventaja clara de separar las dependencias: el comportamiento ante los fallos externos queda expresado en el contrato y se puede probar sin levantar toda la infraestructura.
En el servicio de historia clínica, este tipo de necesidad es todavía más evidente. Allí existen integraciones para firma ECDSA, sellado de documentos, almacenamiento de anexos y consulta de terminología. Cada una tiene sus propios errores, tiempos de respuesta y condiciones de fallo.
En cambio, el servicio de profesionales es mucho más sencillo en ese aspecto.
No tiene que llamar a otros servicios para registrar una especialidad. No necesita un cliente Feign, un proveedor OAuth ni una clave de firma. Su interacción con el exterior está principalmente relacionada con la base de datos y con un topic de Kafka que refleja el estado de las cuentas.
Podría crear puertos para cada una de esas operaciones, pero en este caso tendría que añadir más interfaces, implementaciones y mapeos sin obtener un beneficio claro.
Para mí, esa fue una de las razones principales para no utilizar hexagonal en ese servicio.
Qué implica trabajar con cada estilo
Los dos enfoques tienen sus propios costos. La diferencia es cuándo aparecen y qué problema intentan resolver.
| Por capas | Hexagonal | |
|---|---|---|
| Archivos por caso de uso | Menos | Más, normalmente con puertos, adaptadores y modelos propios |
| Lectura inicial del proyecto | Sencilla para quien conoce Spring | Requiere entender cómo se relacionan las capas y los puertos |
| Probar reglas sin infraestructura | Puede ser más difícil si las reglas están mezcladas con JPA | Más directo cuando el dominio es Java puro |
| Cambiar la persistencia | Puede afectar a la capa de servicio | El cambio suele concentrarse en un adaptador |
| Riesgo habitual | Que las dependencias de JPA se filtren hacia otras partes | Crear abstracciones que realmente no hacen falta |
En un proyecto pequeño, una estructura por capas puede ser suficiente y bastante cómoda de mantener.
El problema aparece cuando el servicio empieza a crecer, incorpora más integraciones o necesita manejar diferentes formas de fallo. En ese momento, tener las dependencias bien separadas puede facilitar bastante el trabajo.
Pero también puede ocurrir lo contrario. Si el servicio es sencillo y no tiene ese tipo de necesidades, introducir puertos y adaptadores para cada operación puede terminar haciendo que el código sea más difícil de seguir.
No creo que haya una respuesta universal. Lo que sí creo es que conviene entender qué problema estamos intentando resolver antes de introducir más estructura.
Las preguntas que me hago antes de elegir
Con el tiempo, he terminado utilizando algunas preguntas para decidir qué enfoque tiene más sentido en cada servicio.
1. ¿Con cuántos sistemas externos tiene que trabajar?
Si el servicio prácticamente solo trabaja con su base de datos, una arquitectura por capas puede ser suficiente.
Si tiene varias integraciones, cada una con sus propios errores, tiempos de espera y mecanismos de recuperación, la arquitectura hexagonal empieza a tener más sentido.
No es una regla matemática. Es una forma de identificar cuándo el aislamiento puede aportar algo útil.
2. ¿Dónde están las reglas de negocio?
Hay reglas que pertenecen claramente a una entidad. Por ejemplo, que un código tenga un formato determinado o que un estado no pueda cambiar directamente a otro.
Otras reglas necesitan coordinar varios colaboradores o consultar información externa.
En ambos estilos se pueden modelar las invariantes de una entidad. La diferencia aparece cuando el caso de uso tiene que coordinar varias dependencias y queremos mantener esa lógica separada de los detalles técnicos.
3. ¿Necesito probar las reglas sin utilizar la base de datos?
Si la respuesta es sí y esto ocurre con frecuencia, tener un dominio aislado puede resultar muy útil.
No siempre es necesario aislar absolutamente todo, pero cuando las reglas de negocio son importantes y tienen muchas combinaciones, poder probarlas con Java puro simplifica bastante el proceso.
4. ¿Es probable que cambie la infraestructura?
Si todavía estoy evaluando el almacenamiento, el proveedor de firma o la forma de comunicarme con otro servicio, tener una interfaz propia puede ayudar a evitar que esas decisiones se propaguen por todo el código.
Si la infraestructura es estable y el servicio es sencillo, quizá no haga falta añadir esa capa de abstracción desde el principio.
En Clínica, estas preguntas me llevaron a utilizar arquitectura hexagonal en pacientes, historia clínica, admisiones, contratación e identidad. El servicio de profesionales, en cambio, quedó con una arquitectura por capas.
En microservicios, el límite importante es el servicio
Una cosa que me ayuda a entender esta convivencia es recordar que cada microservicio tiene su propio límite.
Desde el exterior, un servicio expone una API REST, unos eventos y unos formatos de error. Los demás servicios no deberían depender de cómo están organizados sus paquetes internos.
Por eso, no veo un problema en que un servicio utilice arquitectura hexagonal y otro utilice una estructura por capas. Mientras ambos respeten los contratos que exponen, pueden funcionar dentro del mismo sistema.
En mi caso, hay decisiones que intento mantener comunes en todos los servicios:
- El formato de errores basado en
ProblemDetaily los manejadores compartidos decommons-web. - La autenticación, los roles y los permisos mediante
commons-security. - El uso de UUID públicos en las URLs y del documento como filtro.
@Versionjunto conIf-Matchpara las escrituras que requieren control de concurrencia optimista.- La auditoría con Envers y el usuario obtenido del token.
- La publicación de eventos mediante outbox, evitando escribir directamente en Kafka desde el caso de uso.
- Las migraciones con Flyway y un usuario de aplicación sin permisos de
DELETEni DDL.
Estas decisiones forman parte de las reglas comunes del sistema.
La organización interna, en cambio, puede variar según las necesidades de cada servicio.
Dicho de otra forma: intento que el sistema sea consistente en lo que expone y en las reglas que todos deben cumplir, pero no necesariamente en la forma exacta en que cada servicio organiza su código.
La arquitectura también se tiene que poder comprobar
Para mí, una convención que solamente está escrita en un documento termina siendo difícil de mantener.
Por eso utilizo ArchUnit para comprobar las dependencias entre paquetes. La idea es que las reglas arquitectónicas no dependan únicamente de que alguien las recuerde al escribir código.
En el servicio hexagonal, por ejemplo, puedo definir reglas como estas:
@ArchTest
static final ArchRule layersOnlyDependInward = layeredArchitecture()
        .consideringOnlyDependenciesInLayers()
        .layer("Domain").definedBy("..patient_service.domain..")
        .layer("Application").definedBy("..patient_service.application..")
        .layer("Infrastructure").definedBy("..patient_service.infrastructure..")
        .whereLayer("Infrastructure").mayNotBeAccessedByAnyLayer()
        .whereLayer("Application").mayOnlyBeAccessedByLayers("Infrastructure")
        .whereLayer("Domain").mayOnlyBeAccessedByLayers(
                "Application", "Infrastructure");
También puedo evitar que el dominio dependa directamente de componentes relacionados con web, seguridad o clientes remotos:
@ArchTest
static final ArchRule domainIgnoresWebAndRemoteCalls = noClasses()
        .that().resideInAPackage("..patient_service.domain..")
        .should().dependOnClassesThat().resideInAnyPackage(
                "org.springframework.web..",
                "org.springframework.http..",
                "feign..",
                "jakarta.servlet..",
                "org.springframework.security..",
                "org.springframework.cloud..");
En el servicio por capas, las reglas son diferentes:
@ArchTest
static final ArchRule dependenciesOnlyGoDown = layeredArchitecture()
        .consideringOnlyDependenciesInLayers()
        .layer("Web").definedBy("..practitioners_service.web..")
        .layer("Service").definedBy("..practitioners_service.service..")
        .layer("Repository").definedBy("..practitioners_service.repository..")
        .whereLayer("Web").mayNotBeAccessedByAnyLayer()
        .whereLayer("Service").mayOnlyBeAccessedByLayers("Web")
        .whereLayer("Repository").mayOnlyBeAccessedByLayers("Service");
Y, por ejemplo, puedo evitar que la capa web acceda directamente a clases de persistencia:
@ArchTest
static final ArchRule theWebLayerNeverTouchesPersistence = noClasses()
        .that().resideInAPackage("..practitioners_service.web..")
        .should().dependOnClassesThat().resideInAnyPackage(
                "..practitioners_service.repository..",
                "jakarta.persistence..",
                "org.hibernate..",
                "org.springframework.data..");
El objetivo no es que los dos servicios tengan las mismas reglas. Cada uno tiene las suyas, de acuerdo con su estructura.
Lo que sí quiero es que las dependencias sigan una dirección definida y que una modificación que rompa esa regla haga fallar el build.
De esa manera, “por capas” no significa que cada clase pueda depender de cualquier otra. También puede haber una estructura clara y verificable.
Cuando los dos estilos empiezan a parecerse
Hay un detalle del servicio por capas que me pareció interesante.
La lectura del estado de las cuentas es la única comunicación externa que tiene ese servicio. Cuando estaba organizando el código, me di cuenta de que esa dependencia no encajaba muy bien dentro de las tres capas principales.
No era exactamente web, tampoco era un servicio de negocio ni un repositorio. Era un colaborador externo.
Así que terminó en su propio paquete, con una regla de ArchUnit que evita que dependa de las otras capas:
@ArchTest
static final ArchRule theClientDependsOnNoLayer = noClasses()
        .that().resideInAPackage("..practitioners_service.client..")
        .should().dependOnClassesThat().resideInAnyPackage(
                "..practitioners_service.web..",
                "..practitioners_service.service..",
                "..practitioners_service.repository..");
En cierto sentido, esto se parece bastante a un puerto.
La diferencia es que en el servicio hexagonal separar las dependencias externas es parte de la estructura principal. En el servicio por capas, esa separación apareció porque había una necesidad concreta.
Esto también me hizo pensar que las dos arquitecturas no son necesariamente mundos completamente separados. Hay ideas que se pueden aplicar en ambos estilos, siempre que tengan sentido para el problema que se está resolviendo.
Lo que he aprendido de esta decisión
Lo que más me ha cambiado la forma de elegir una arquitectura no es haber aprendido más nombres o patrones. Es haber tenido que tomar una decisión concreta dentro de un sistema que estoy construyendo.
Antes tendía a pensar que, si una arquitectura funcionaba bien en un servicio, lo más ordenado era repetirla en todos los demás.
Ahora intento mirar primero las necesidades del servicio.
¿Con qué sistemas tiene que comunicarse? ¿Qué ocurre si esas dependencias fallan? ¿Qué tan complejas son sus reglas de negocio? ¿Necesito cambiar la infraestructura? ¿Cuánto código adicional estoy dispuesto a mantener para conseguir ese aislamiento?
También he aprendido que la calidad del código no depende exclusivamente de utilizar arquitectura hexagonal.
Cosas como evitar setters públicos innecesarios, utilizar métodos que expresen intención, modelar correctamente los estados, mantener DTO propios en las fronteras, controlar la concurrencia optimista y registrar auditoría son decisiones que se pueden aplicar en ambos estilos.
Si esas reglas no se cumplen, tener puertos y adaptadores no va a solucionar el problema.
Al final, elegir una arquitectura consiste en decidir dónde tiene sentido asumir la complejidad.
La arquitectura por capas puede ser suficiente para un servicio. La arquitectura hexagonal puede ser más adecuada para otro. Lo importante es que la decisión se pueda explicar, que las dependencias estén controladas y que la estructura ayude a resolver los problemas reales del sistema, en lugar de convertirse en trabajo adicional por sí mismo.